En ingeniería y computación hay un concepto que se repite mucho al analizar la forma de resolver algún problema: el determinismo. Una forma simple de entenderlo es si dos ejecuciones de un proceso, para los mismos parámetros de entrada, siempre terminan en el mismo resultado. Por ejemplo, si uso una calculadora y aprieto los botones 2, +, 2, = me va a salir 4, y nunca me va a salir algo distinto. Desde el circuito del botón hasta la rutina que se ejecuta en el procesador, todo es predecible y no hay nada aleatorio o estocástico (que tiene algún elemento de azar) que pueda cambiar el resultado en algunos casos.
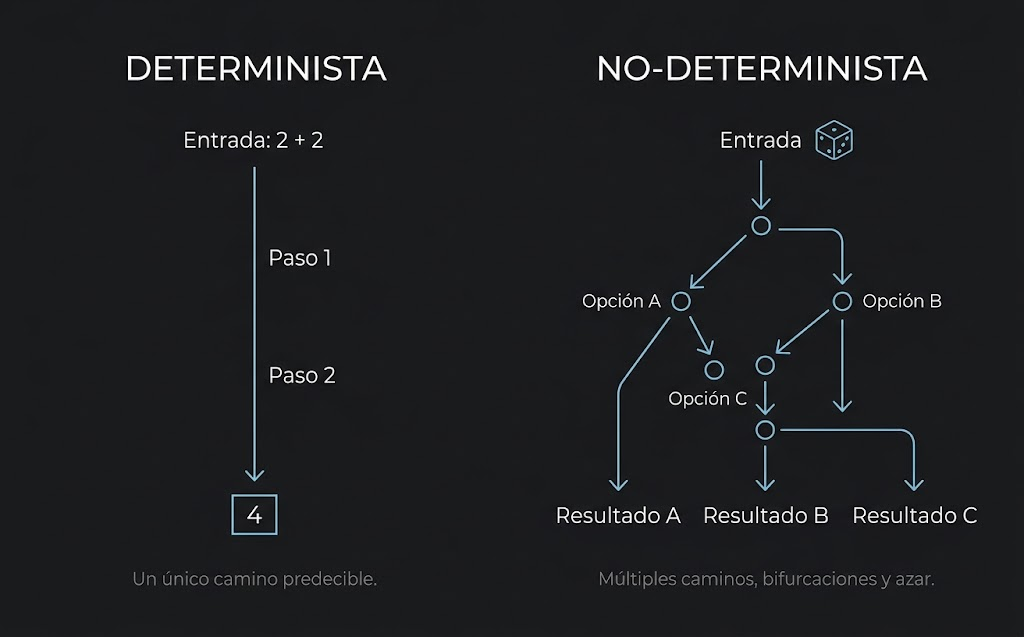
Por otro lado, están los procesos que son no-deterministas: imagina que están eligiendo quién se come el último pedazo de pizza y deciden tirar una moneda. El único parámetro es si la persona elige cara o sello. El proceso es que alguien tira una moneda y la salida es si gana o no. Para los mismos parámetros de entrada, a veces gana, otras veces pierde. El diagrama de abajo lo resume bien:
Los humanos, en general, somos no-deterministas. Si nos preguntan nuestra opinión podemos cambiarla, incluso si nos preguntan dos veces seguidas. Se podría decir que somos inconsistentes también. De hecho como humanidad hemos tratado de resolver los problemas de manera determinista y predecible, con máquinas y manuales de procedimientos en vez de criterios individuales.
Si nos vamos al mundo del software, estamos acostumbrados a que algunos pasos en el proceso sean deterministas, como la compilación desde código de fuente a “lenguaje de máquina”, o la misma ejecución de estos programas en computador. Pero como siempre hay humanos metidos en la mitad, sí hay partes no-deterministas en el proceso completo, como la escritura del código desde un diseño. Pero aguantamos ese no-determinismo (porque no tenemos otra opción) y hemos construido controles y procesos para bajar el riesgo de equivocarnos, como análisis de código estático, pruebas automatizadas y revisiones de código.
Los beneficios del determinismo en procesos de negocio son bastante evidentes. Si las reglas de mi sistema son estrictas y cada paso determina completamente el siguiente, puedo llegar a tener una confianza total en que todo va a funcionar como espero. Nadie preferiría que a veces el saldo de tu cuenta en el banco esté mal calculado, o que el resultado de una validación de identidad sea incorrecta de manera deliberada.
Excepto cuando agregar no-determinismo me entrega más beneficios que el riesgo de equivocarme.
Encontrando números primos con un poco de riesgo
Revisar si un número es primo no es un problema particularmente difícil. De hecho el ejemplo de más abajo es la forma más simple de hacerlo, pero también es la más ineficiente. Estamos revisando si existe un divisor del número evaluado con fuerza bruta, probando un número tras otro.
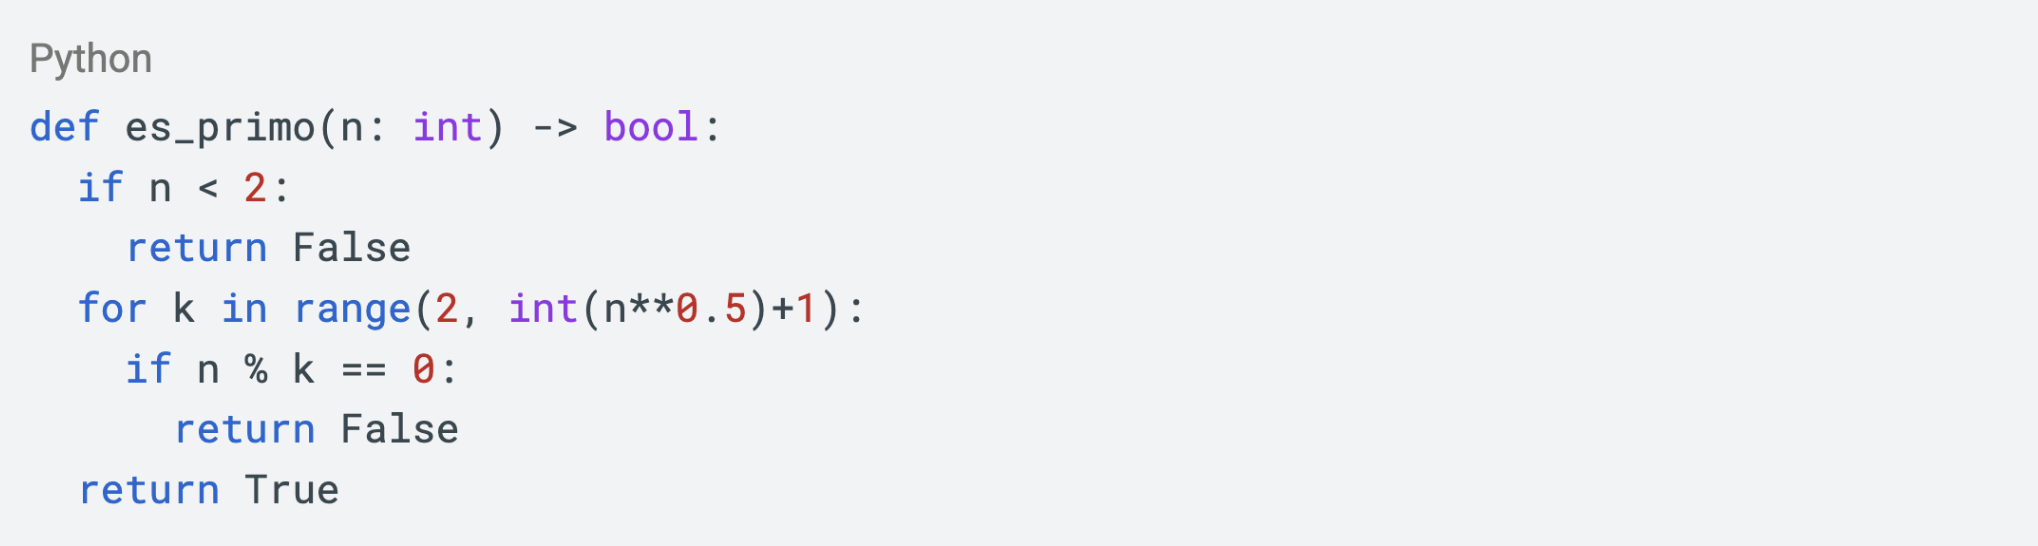
El algoritmo es totalmente determinista. Para un n dado, los pasos que ejecuta son siempre los mismos. De hecho la cantidad de pasos que ejecuta se puede calcular: raíz de n si el número es primo o su divisor más chico si el número es compuesto.
El algoritmo anterior es exponencial sobre el largo del número (definido como la cantidad de dígitos que necesito para escribirlo) y por mucho tiempo no se sabía si existía un algoritmo general, determinista y eficiente en tiempo que lo resolviera.
Eso hasta el año 2002 cuando Agrawal, Kayal y Saxena, matemáticos del instituto tecnológico de Kanpur en India publicaron un paper con uno de los mejores títulos posibles: “PRIMES is in P”. O sea, el problema de verificar si un número es primo sí tiene un algoritmo general que es polinomial sobre el largo del número (un algoritmo polinomial es fundamentalmente más eficiente que uno exponencial, pero sólo asintóticamente. Para números chicos puede ser mucho más lento en la práctica).
Más allá de lo compleja que puede sonar la explicación anterior, uno podría pensar que en ese momento todas las implementaciones cambiaron a este nuevo algoritmo con una complejidad computacional muchísimo más baja que los algoritmos conocidos, pero la realidad es distinta. Eso porque muchos años antes Miller y Rabin habían desarrollado otro algoritmo para verificar si un número es primo, pero con una gran diferencia: era un algoritmo aleatorizado, y por lo tanto no determinista, o sea, a veces se podía equivocar.
El algoritmo se basa en un pequeño teorema que hace casi 400 años enunció el matemático francés Pierre de Fermat, que dice que para cualquier número primo p y cualquier entero a menor a p, se cumple que
$$a^p \equiv a \pmod{p}$$El contrapositivo de esto es que si encuentro un caso donde la equivalencia anterior no se cumple, entonces el número no es primo, así que si genero muchos números aleatorios y nunca encuentro un contraejemplo, lo más probable es que mi número sea efectivamente primo. El algoritmo final de Miller-Rabin usa algunos controles adicionales para dar más garantías de correctitud, pero en esencia se comporta igual:
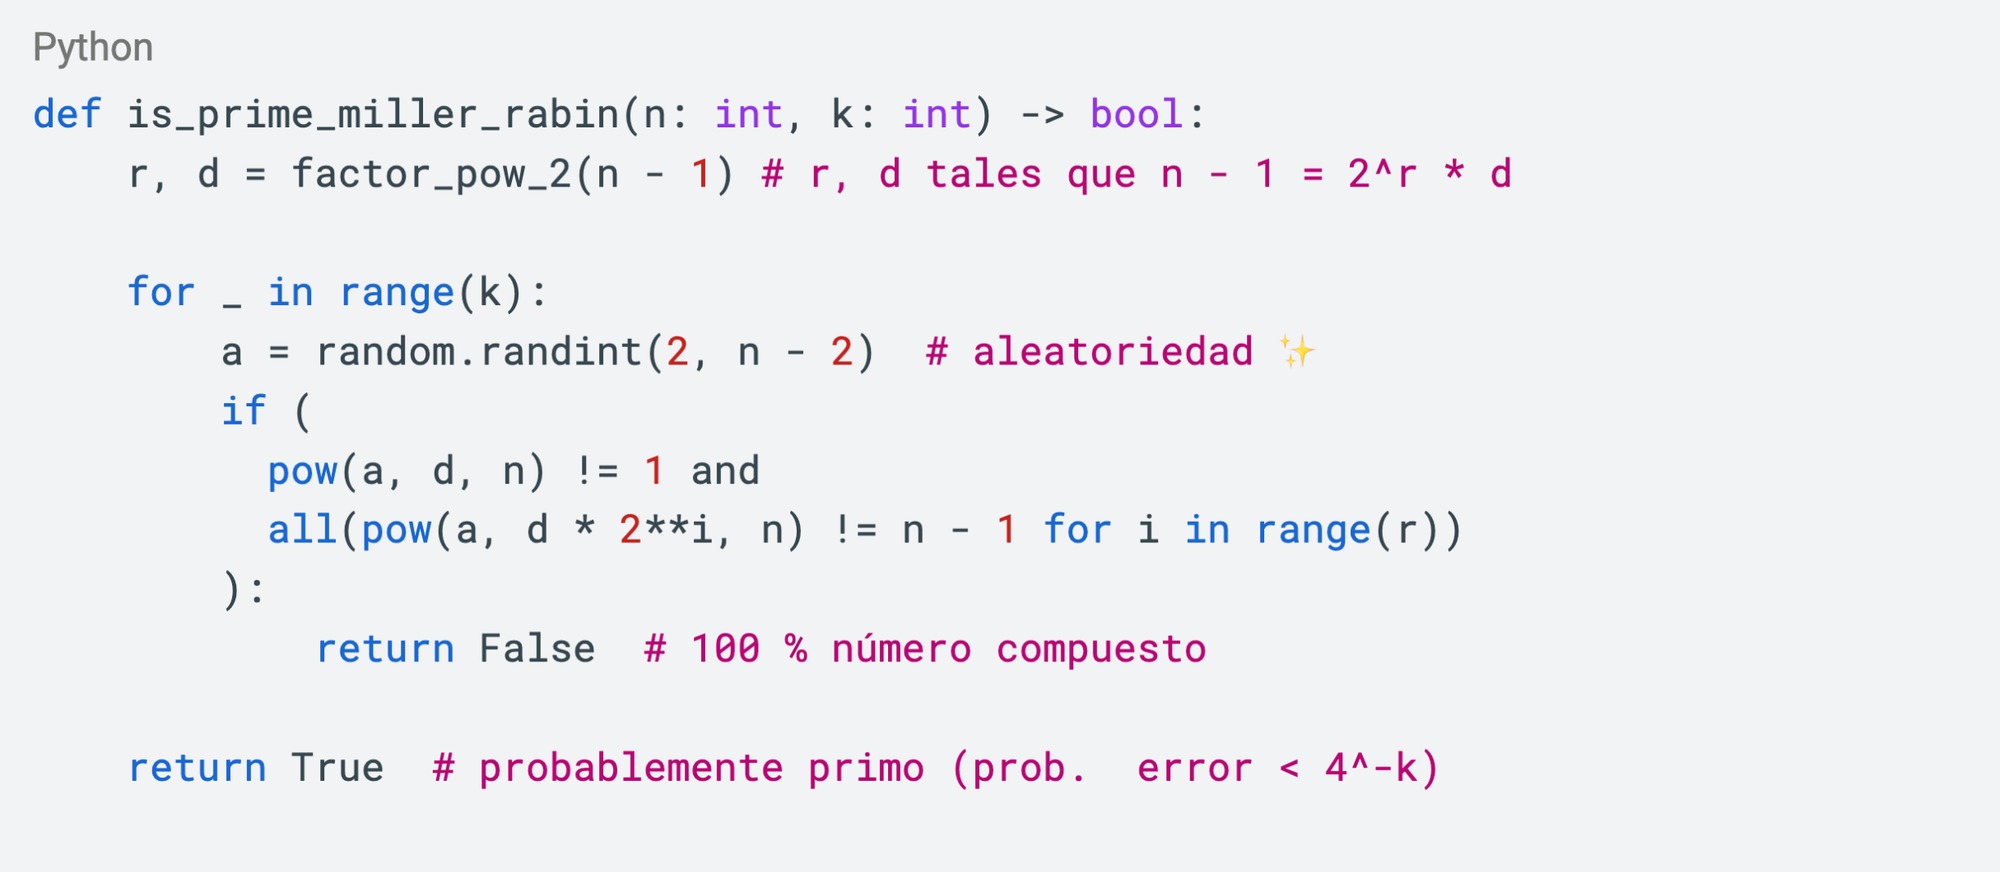
Una propiedad interesante de este algoritmo es que usa un parámetro k con el que puedo controlar la probabilidad de equivocarme. Mientras más grande k, menos probable es que el resultado sea incorrecto.
En la práctica usar el algoritmo estocástico es muchísimo más rápido que usar el algoritmo polinomial determinista de Agrawal, Kayal y Saxena, incluso si elegimos valores de k que hacen despreciable la probabilidad de error. Por ejemplo con k=100 la probabilidad de error es menor a la probabilidad que un rayo cósmico cambie un bit del procesador ejecutando el algoritmo (que aunque suene a ciencia ficción, ha ocurrido antes), con unos cientos o miles de operaciones, comparado con la cantidad astronómicamente grande de pasos que podría necesitar el algoritmo determinista. Solo tenemos que permitirnos equivocarnos un poco.
Criptografía: ¿cómo convencer a un daltónico de que es daltónico?
Shafi Goldwasser y Silvio Micali presentaron en 1984 el paper Probabilistic Encryption. En él mostraron cómo usar aleatoriedad para cifrar mensajes con garantías formales sobre la información que un atacante puede obtener. Años antes, el matemático venezolano Manuel Blum (supervisor de doctorado de Micali, Goldwasser y posteriormente de Luis Von Ahn, matemático guatemalteco fundador de reCAPTCHA y Duolingo) fue pionero en este tipo de técnicas con genialidades como un algoritmo para tirar una moneda por teléfono.
En criptografía, la aleatoriedad permitió algo más que aceptar una pequeña probabilidad de error: también permitió formular y alcanzar garantías de seguridad que no teníamos antes. Uno de los casos de uso más interesantes es el de las Zero Knowledge Proofs (que Goldwasser y Micali desarrollaron con Rackoff en 1985), que consiste en poder demostrar un hecho, sin demostrar nada más que el hecho mismo. Suena medio metafísico o tautológico, pero es más fácil entenderlo con un ejemplo:
Imagínense que tienen un amigo daltónico (siempre hay uno por ahí) que no cree en el no-daltonismo, o sea que cree que todo el mundo ve igual que él. Así que diseñan el siguiente ejercicio para demostrárselo: le pides a tu amigo que tome una pelota azul y otra verde (indistinguibles para él), toma cada una en una mano, las esconde detrás de su espalda y elige cambiarlas o no. Después las vuelve a mostrar y pregunta “¿las cambié?”. Si la respuesta es correcta, nuestro amigo puede creernos, pero hay un 50% de probabilidad de achuntarle, así que repite el ejercicio. Si la respuesta es correcta después de 10 veces, la probabilidad de que sea suerte es menos del 0,1 %, y nunca dijimos cuáles eran los colores de las pelotas.
Este mismo principio se ocupa en métodos criptográficos de firma digital o cifrado para conseguir sistemas más rápidos, baratos y con las mismas (o mejores) garantías de seguridad.
El salto en capacidades y beneficios que trajo espolvorear aleatoriedad sobre criptografía clásica es una maravilla. Aunque las criptomonedas no gozan de la mejor fama actualmente, muchas de ellas ocupan principios desarrollados con la teoría de Goldwasser. Por ejemplo ZCash que ocupa las zk-SNARKs o Monero (en su versión original) con Traceable Ring Signatures.
Software y agentes: ¿cómo controlar las alucinaciones?
Estamos en tiempos de cambios acelerados y grandes dudas de cómo va a ser el futuro. Y uno de los gremios donde existen más interrogantes es la ingeniería de software.
Hoy existe una tendencia que crece cada vez más de presionar a equipos de desarrollo a “soltar” el determinismo en el proceso de escritura de código. Que confiemos en que los agentes van a escribir las cosas bien. Y si pienso en los problemas anteriores, donde agregar un poquito de aleatoriedad expandió las fronteras de lo que era posible de una manera significativa y controlada, creo que vamos a llegar a ese punto. Pero hay un matiz importante: en los ejemplos anteriores la probabilidad de equivocarse viene de la aleatoriedad del sistema y puedo controlarla. Yo tiro la moneda para elegir el siguiente número o cambiar o no las pelotas de mano, y por lo tanto puedo evaluar bien el riesgo que estoy tomando. En los LLMs el error es en gran parte intrínseco al modelo, a priori no sabemos cuándo ni cómo el modelo va a alucinar, ni menos parametrizar la probabilidad de error.
Pero sí hay algo que podemos rescatar de los ejemplos anteriores. En ambos casos la posibilidad de equivocarnos está en solo una de las respuestas. En Miller-Rabin solo se puede equivocar cuando dice que un número es primo (nunca si es compuesto) y la prueba del daltónico solo cuando las pelotas son distintas (o no existe el daltonismo). En ambos casos tengo una forma rápida y efectiva de decir “esto definitivamente está mal”.
Lo mejor es que en el mundo del software esto ya lo hacemos desde hace mucho tiempo con lo que podríamos llamar andamiaje. Históricamente lo hemos usado para disminuir errores humanos, pero ahora nos sirve para bajar la entropía de lo que los agentes pueden generar con ejemplos, patrones y reglas estructuradas. Herramientas como linters, formatters y de análisis estático de código nos ayudan a controlar la impredecibilidad del código generado y bajar la probabilidad que alguna alucinación o error termine llegando a un sistema en producción. Y de a poco podemos ir tomando confianza en que la probabilidad que se equivoque sea tan baja, que tal como los ejemplos anteriores, es irrelevante para efectos prácticos que sea no-determinista.
El desafío hoy en día es explorar este no-determinismo que hace poco era inviable por la inmensa probabilidad de error. Tenemos que construir herramientas, metodologías y formar personas que entiendan el impacto y riesgo de movernos a un espacio en el que tenemos menos control, pero un aumento importante de capacidades. A diferencia del no-determinismo humano, aún no entendemos bien cómo y cuándo se equivocan los LLMs y seguimos encontrando tropiezos estúpidos como contar la cantidad de letras en una palabra.
Por eso creo que todavía no estamos en una posición donde podemos delegar completamente lo que hace solo unos meses protegíamos con orgullo y una buena dosis de soberbia. Tal vez falten mejores modelos. Tal vez falte más andamiaje. Pero creo que ese punto va a llegar. Y en ese momento podremos abrazar este no-determinismo como un viejo amigo que siempre estuvo ahí, despeinando y abriendo horizontes en la ciencia y tecnología. Ojalá con más control y entendimiento de sus límites y capacidades.